日志分析
「日志分析」页(/analysis,管理员)自动聚合日志指标,无需手动查询:
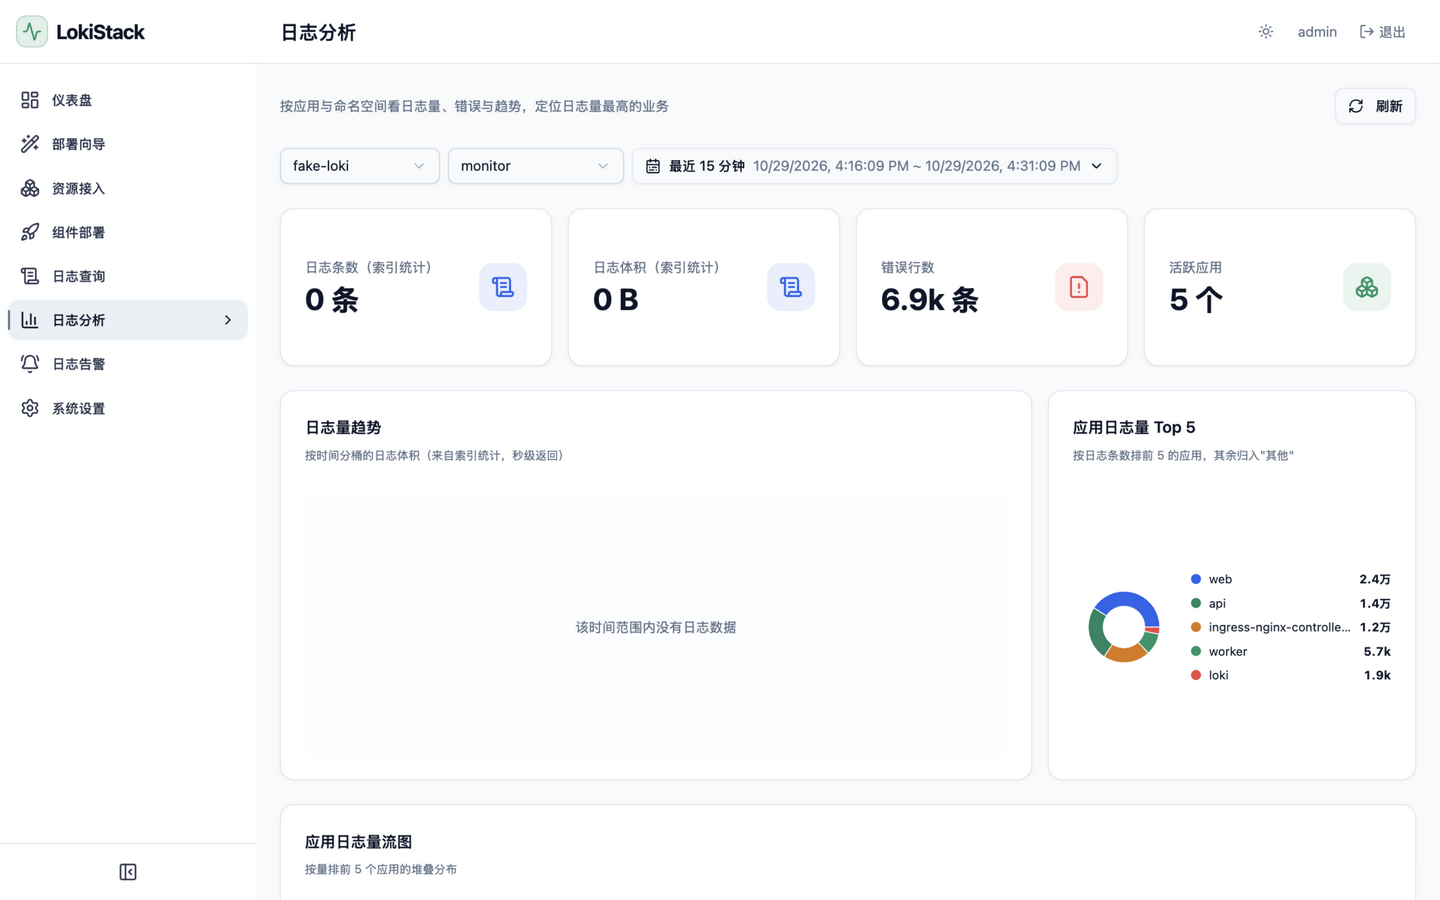
- 统计卡:日志总量、日志体积、错误行数、活跃应用
- 趋势折线:按时间分桶的日志体积(≤12 小时 15 分钟一桶,>12 小时 1 小时一桶)
- 应用排行:按日志体积排 Top 10,支持 10/30/50 与前端分页,点击「查看日志」跳转查询页
- 每日日志量:平台留存历史,支持 7 / 30 / 90 / 365 天切换(独立于上方时间范围)
- Ingress 访问分析:自动识别 ingress-nginx 访问日志,PV/UV、状态码、慢请求与接口排行;未安装 ingress-nginx 时自动折叠
数据来源与耗时
| 数据 | 来源 | 耗时 |
|---|---|---|
| 总量/体积趋势、总条数 | Loki 索引接口(index/volume_range、index/stats),只读 chunk 元数据 |
百毫秒级 |
| ≤1 小时范围的应用排行 | 实时扫描日志内容(count_over_time) |
5 分钟窗口约 5~10 秒 |
| >1 小时范围的应用排行 | 平台按小时预聚合快照(每小时第 5 分钟抓上一个完整小时) | 毫秒级 |
一次分析页要跑多条按应用的重查询,因此筛选栏改条件后点「刷新」才生效;
应用排行卡片滚动到可视区才发起重查询,避免首屏一起等。
应用排行的「体积」口径
预聚合快照对每个应用每小时同时留存 条数 + 体积:
- 条数走
count_over_time(要解码日志内容,一小时代价高,每小时后台跑一次) - 体积走
index/volume(Loki 索引接口,一个应用约 80ms,所以长范围排行也能按体积排序)
体积优先排序的原因:条数会被高频短日志主导(一条 INFO 刷屏 vs 一条大 JSON),
用户真正关心的是「哪个应用把日志量吃掉了」。
体积列上线前抓的小时只有条数,页面会在表格下方提示
「其中 N/M 小时有体积数据…」——不要把这个提示当成故障,
它是在说明这段时间的体积偏小是采样口径问题,而不是应用体积真的小。
每日日志量的「未留存」
每日量来自平台自己的留存库(默认保留 400 天),不受 Loki retention(72 小时)限制。
- 今天的柱子是「进行中」,每 30 分钟刷新一次;零点后 1 分钟结算前一天
- 灰色柱 = 平台没有留存记录(平台当天没运行 / 超出留存期),不是「当天没有日志」
- 如果缺失的天画成 0,30/90 天视角会出现大片空柱,容易被误读成「以前日志量很低」甚至「系统停摆过」
时间范围与数据源在页面顶部切换;指标查询经服务端聚合,开销远低于拉取原始日志。